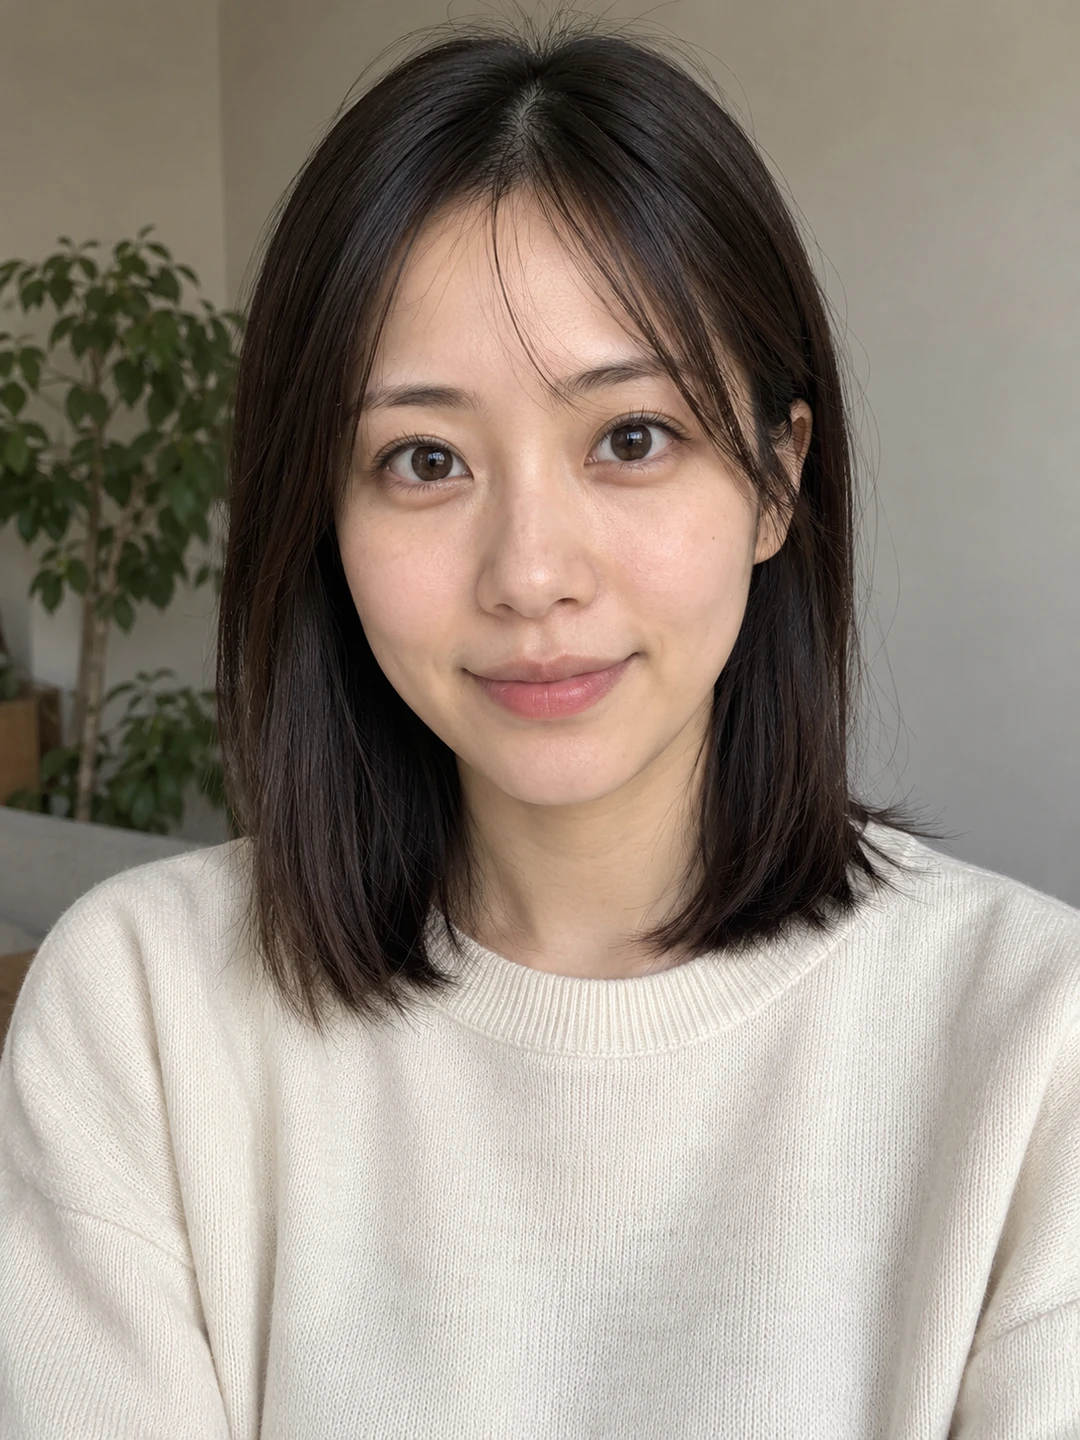
每个人都有自己的参考照
A、B 各上传一张不同的单人照。脸部清楚、光线简单,比复杂合照更方便模型参考人物特征。
人物 A · 左侧
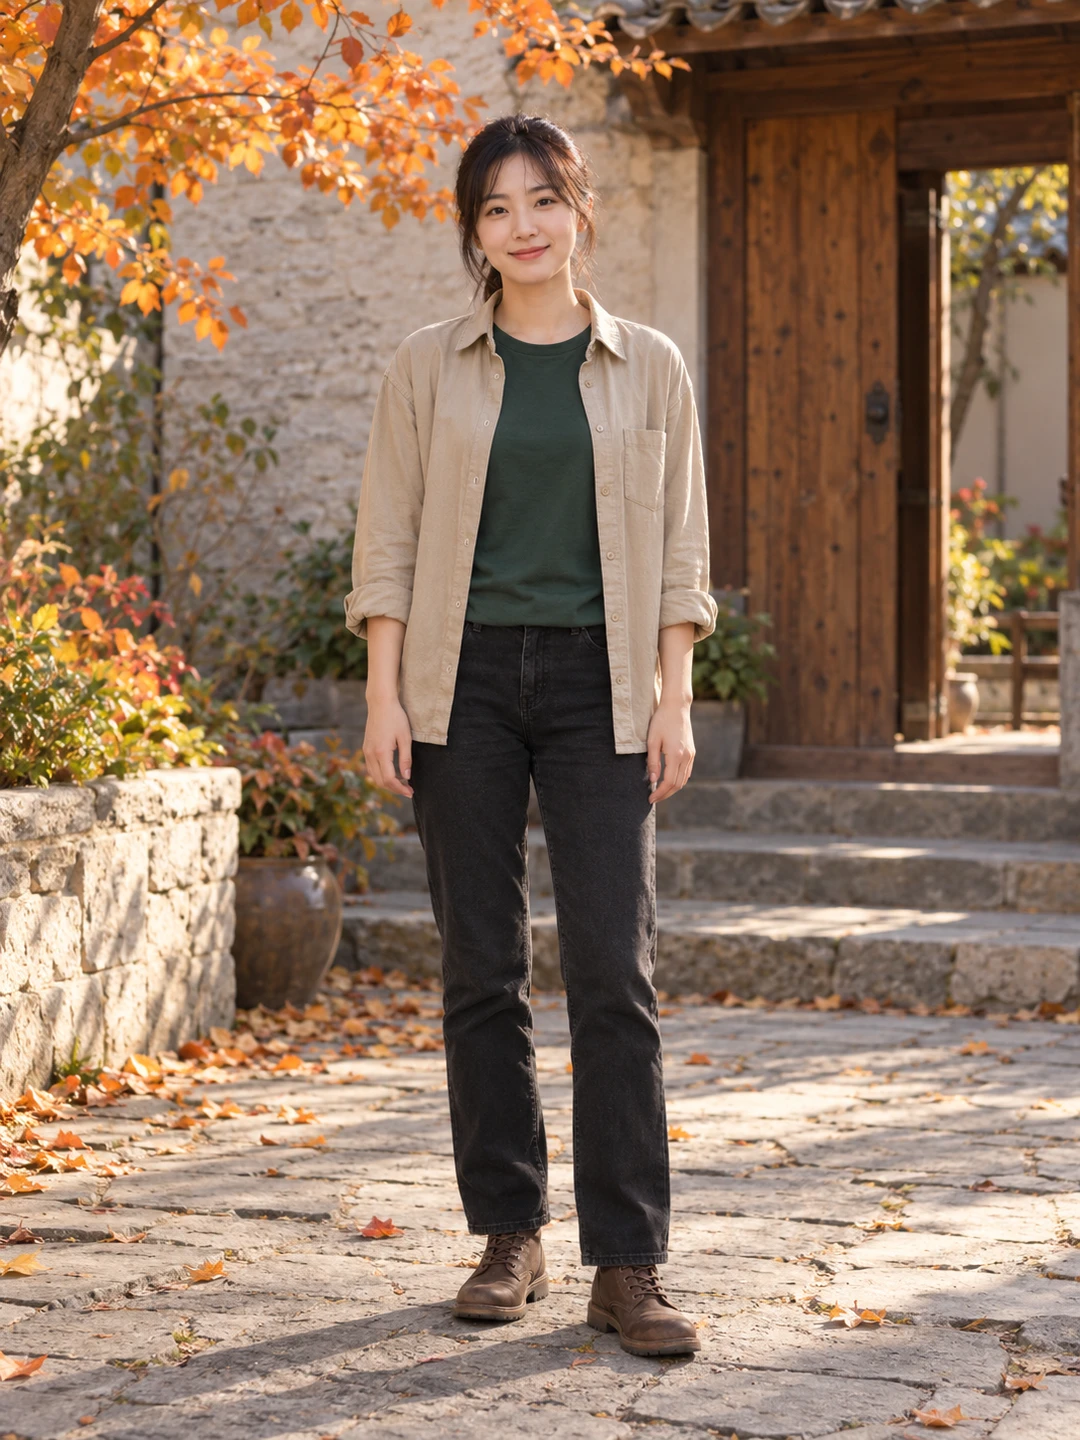
人物 B · 右侧
示例输入照片
分别上传两位人物的清晰单人照,生成你的双人视频。
⏱ ⏱ 视频生成约需 5-9 分钟,等待时可浏览其他标签页。
本次生成预留 152 积分,按实际用量结算
AI 双人说唱把两张照片中的人物带入同一段表演。分别上传清晰单人照,生成新的摄影棚画面、节拍与说唱人声。
用于测试的原创 AI 成年人物输入照;这两张照片是输入示例。
A、B 各上传一张不同的单人照。脸部清楚、光线简单,比复杂合照更方便模型参考人物特征。
预设要求 A 在左、B 在右,进入暖橘色摄影棚,以小幅独立动作完成连续的双人同框表演。
流程同时请求原创节拍、说唱人声与视频。分享前请检查声音和人脸,具体歌词、音色与口型时序可能变化。
按 A、B 顺序,各添加一张清晰的成年人物单人照,并确认你有权使用这些照片。
预设为 8 秒、720p、16:9,并开启生成音频。提交前可在按钮旁查看本次积分用量。
完整播放视频并听取声音,确认两个人物效果后,从结果面板下载。保存的结果也可在“我的视频”查看。
请上传恰好两张不同的单人照。第一张是人物 A,第二张是人物 B;本工具的预设输入是分开的参考照片。
可以,预设会根据分开的参考图生成共同的摄影棚场景。请使用面部无遮挡的清晰照片,人物特征还原程度可能变化。
本工具请求生成同步音频,包括原创节拍和说唱人声。使用前请完整试听,模型可能改变具体歌词和声音。
当前版本使用原创表演预设,未提供歌曲上传、声音克隆或精确歌词时间轴,也不保证逐字口型同步。
本工具请求生成 8 秒、720p、16:9 的 MP4 视频。提交前会显示本次积分用量,需要登录并有足够积分;完成后可预览和下载。